

Imaginez que vous habitez une maison où la cuisine est dans le jardin, la chambre dans le garage et le salon au bout de la rue. C’est le quotidien d’une infrastructure « legacy » : on stocke sur S3, on traite, et on analyse. Résultat ? Des silos partout et une complexité folle.
En migrant vers le Lakehouse de Databricks, basé sur la technologie Delta Lake, on emménage dans une villa moderne et unifiée. Le but stratégique ? Réunir enfin les données et l’IA sous le même toit pour passer plus de temps à innover.
Le Unity Catalog est bien plus qu’une simple gouvernance, il assure que tout est sécurisé et tracé en un seul point.
Les bénéfices de cette nouvelle architecture :
Sur AWS, notre architecture historique avait le mérite d’exister, mais elle montrait de réelles limites en termes d’agilité et de fluidité. On stockait nos données dans des seaux numériques (S3), on lançait des requêtes SQL (via Athena) et on développait nos modèles dans des carnets de bord isolés (SageMaker).
On codait chacun de notre côté, puis venait l’étape du déploiement manuel : exporter le code pour le transférer sur une autre plateforme interne. Une tâche chronophage et risquée.
Aujourd’hui, le Lakehouse rassemble data engineers, analysts et scientists au même endroit. L’ingestion repose désormais sur des pipelines natifs et automatisés, ce qui élimine définitivement la maintenance laborieuse des anciens scripts sur-mesure.
Auparavant, migrer du code d’une plateforme à une autre était un véritable calvaire : il fallait réécrire chaque ligne à la main, un processus long et coûteux.
Heureusement, nous sommes entrés dans l’ère des assistants intelligents. Pour accélérer cette transition, on s’appuie directement sur l’IA intégrée à Databricks : Genie Code. Cet assistant de codage ne se contente pas de traduire bêtement la syntaxe ; il analyse et modernise le code source intelligemment.
La sécurité reste absolue : tout le travail de conversion se fait dans l’environnement sécurisé de Databricks, garantissant la protection de nos données.
Le match Migration Manuelle vs IA :
Côté traitement, on remplace les boucles lentes par une logique de traitement bien plus performante (ex : MERGE). Résultat : notre modèle XGBoost profitera d’une très grande puissance de calcul pour traiter des millions de lignes en parallèle.
Notre ancien code utilisait Pandas, limité aux calculs sur une seule machine. Pour passer à l’échelle, on bascule sur PySpark, un moteur de calcul distribué exploitant plusieurs machines simultanément.
Côté traitement, on remplace les boucles lentes par une logique de traitement bien plus performante (ex : MERGE). Résultat : notre modèle XGBoost profitera d’une très grande puissance de calcul pour traiter des millions de lignes en parallèle.
5.1. La connexion au puits de données (Azure) : Fini la gestion complexe des anciens buckets S3. Les données arrivent désormais directement via notre puits de données Azure, nativement intégré et accessible au sein d’Unity Catalog.
5.2. L’inventaire de l’existant : On cartographie l’ensemble des traitements actuels. Il s’agit souvent de dizaines, voire de centaines de petits scripts dispersés (requêtes SQL Athena, notebooks SageMaker isolés).
5.3. La traduction massive par l’IA : C’est ici que la magie opère. On soumet cette multitude de scripts disparates à notre assistant Genie Code. L’IA va lire l’ancien code (souvent du Pandas ou du SQL classique) et le transformer automatiquement en langage PySpark adapté au calcul distribué.
5.4. L’optimisation technique : L’IA fait le gros du travail de conversion (les fameux 50 à 80 %), mais l’équipe data repasse sur le code généré. On en profite pour remplacer les anciennes logiques de mise à jour par les commandes ultra-rapides de Delta Lake, comme le MERGE.
5.5. La phase de tests techniques : On exécute les nouveaux pipelines PySpark et on compare les données produites avec celles de l’ancienne architecture pour garantir qu’il n’y a aucune régression ni perte d’information.
5.6. La validation métier : La technique ne fait pas tout ! Les utilisateurs finaux (analystes, décideurs) entrent en piste pour certifier que les indicateurs reconstruits correspondent parfaitement à leur réalité opérationnelle.
5.7. La bascule de la sécurité : Avant de lancer la production, on abandonne les anciens rôles complexes de type IAM. On recrée les droits d’accès de manière centralisée et granulaire directement dans Unity Catalog.
5.8. L’orchestration finale (Workflows) : Une fois validés, on débranche les anciens jobs. L’ensemble des traitements est désormais planifié et monitoré nativement via l’outil Databricks Workflows.
Avec Databricks, Unity Catalog centralise la gouvernance et la sécurité. Ce catalogue unique permet de contrôler les accès et de suivre précisément la vie de la donnée (Data Lineage), de sa source jusqu’à l’analyse finale.
Cela nous permet de monitorer des indicateurs de qualité clés (taux de complétude, taux d’exactitude) en continu. La donnée est ainsi certifiée, sécurisée et directement exploitable.
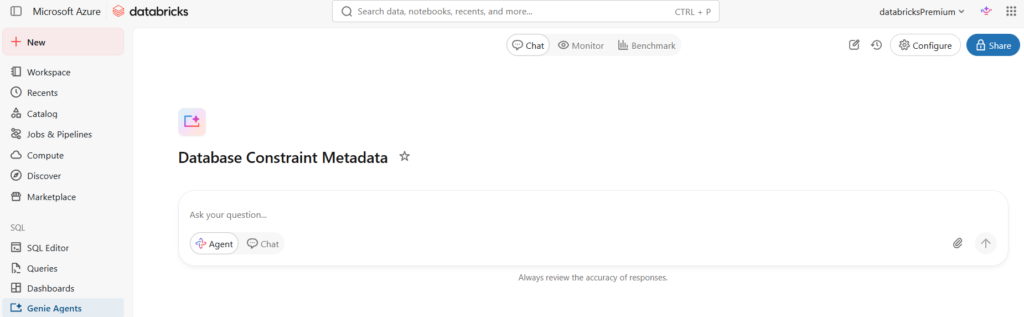
Le meilleur arrive après la migration, lorsque l’espace de discussion intelligent Genie Space donne enfin vie à vos données.
Plus besoin d’être un expert SQL : vous posez des questions en langage naturel (ex : Quelle a été la tendance globale des incidents critiques sur le dernier trimestre ?) et l’IA interroge le catalog pour vous répondre avec des graphiques clairs.
L’IA gère le travail pénible de traduction et de requêtage, nous laissant enfin nous concentrer sur l’essentiel : extraire toute l’intelligence de nos données pour générer de la valeur !🚀